Когда нейросеть путает бренды: как возникают ошибки AI-систем и почему бизнесу уже недостаточно «быть в интернете»
- Главная проблема AI Search: модель может быть уверенной, а сущность – неправильной
- Как был устроен повторный разбор
- Контрольный массив: частные клиники
- Пять типов путаницы, которые особенно опасны для бренда
- Почему наличие ссылок не гарантирует, что ошибка исчезнет
- Какие бренды находятся в зоне повышенного риска
- Как измерять путаницу бренда, а не только «видимость»
- Что бизнесу делать уже сейчас: семь практических шагов
- Что это меняет для SEO, PR и управления репутацией
- Вывод
- Методологические ограничения

|
72 ответа AI-систем |
35 ответов с видимыми URL |
4 ответа с неоднозначными или нерелевантными доменами |
11,4% наблюдаемая доля таких ответов в ссылочном слое |
Важно: 11,4% – не «общая частота ошибок нейросетей». Это доля ответов с видимыми источниками в конкретной выборке, где мы зафиксировали хотя бы один нерелевантный или неоднозначный домен. В статье этот показатель используется как наблюдаемый сигнал риска, а не как универсальный рейтинг точности платформ.
Главная проблема AI Search: модель может быть уверенной, а сущность – неправильной
Когда пользователь спрашивает у AI-ассистента «какую компанию выбрать», он получает не десять синих ссылок, а готовый вывод. В этом и преимущество, и новый риск генеративного поиска: ошибка в распознавании бренда может незаметно перейти в ошибку факта, географии, продукта или репутации.
Классический поиск обычно оставляет пользователю этап проверки: открыть несколько сайтов, сравнить названия, увидеть логотип и домен. Генеративная система сама соединяет фрагменты источников в единый ответ. Если на этапе извлечения или сопоставления сущностей были смешаны две компании с одинаковым или похожим названием, итог может звучать логично – и при этом относиться не к тому бизнесу.
Эта статья – продолжение предыдущего исследования RECOMO для SEOnews о том, какие источники попадают в ответы AI-систем. В том массиве уже обнаружился отдельный класс ошибок, который заслуживает самостоятельного разбора: в 4 из 35 ответов с видимыми источниками встречались нерелевантные или неоднозначные домены. Самый наглядный эпизод – совпадение названия российского автомобильного бренда ORIS с швейцарским часовым брендом Oris: в источниковый слой по автомобильной теме попадали магазины часов.
То есть модель не обязательно «выдумывает» факт с нуля. Иногда она честно находит реальную страницу – просто про другую сущность.
Как был устроен повторный разбор
Базовый массив был собран 28 июля 2026 года в товарной категории автомобильных аксессуаров. Мы проверили 12 коммерческих и информационно-коммерческих сценариев в шести AI-системах: ChatGPT, Gemini, Claude, Perplexity, Алисе и GigaChat. В итоговую матрицу вошли 72 первых ответа – по одному на каждую пару «система – сценарий».
В каждом ответе фиксировались:
-
названные бренды и их позиции;
-
аргументы рекомендации;
-
видимые URL и домены;
-
соответствие источника обсуждаемому бренду и продуктовой категории;
-
фактические и сущностные несоответствия – когда информация выглядит правдоподобно, но относится к другой компании, связанному бренду или иному рынку.
Всего в массиве было 382 брендовых упоминания и 427 ссылочных появлений на 93 доменах. Видимые URL присутствовали в 35 ответах. Именно для этих 35 ответов можно было отдельно проверить «чистоту» источникового слоя. В 4 ответах обнаружились нерелевантные или неоднозначные домены – 11,4% от ответов, где ссылки были видимы.
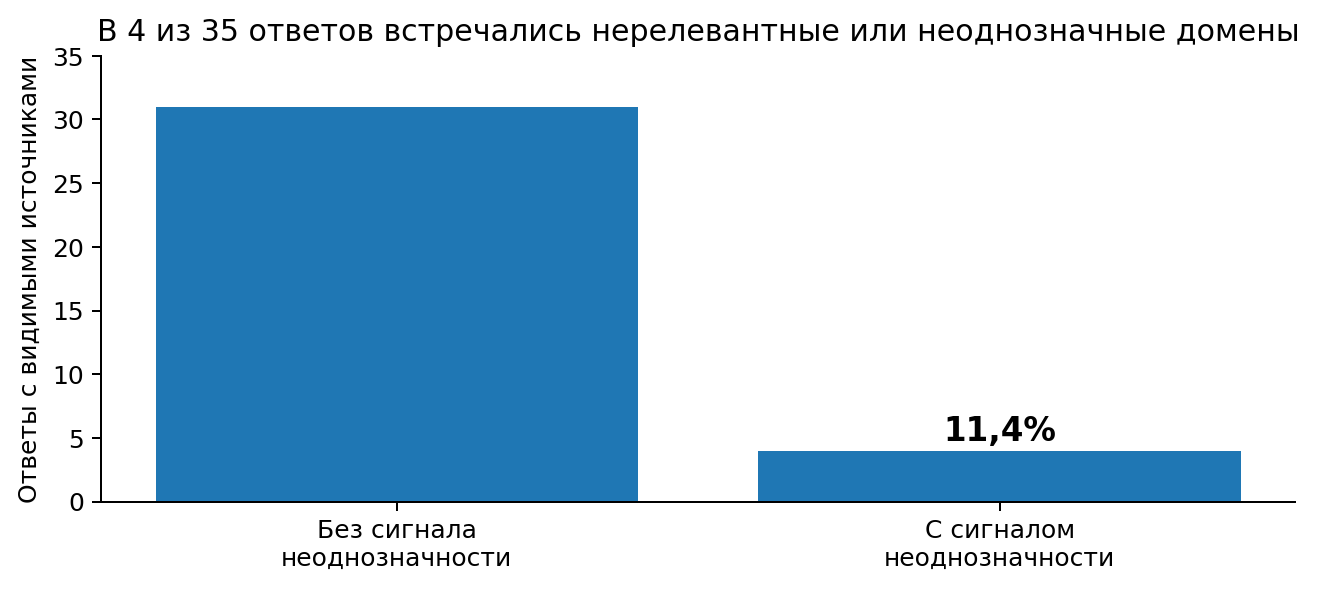
Рисунок 1. Наблюдаемый сигнал неоднозначности в ответах с видимыми источниками. Это не общая частота ошибок всех AI-систем
Контрольный массив: частные клиники
Дополнительно использовался контрольный медицинский массив из 36 ответов ChatGPT и 180 рейтинговых позиций по сценариям выбора частных клиник Москвы. Он не включался в расчет 11,4%, но показал сходный тип проблемы: AI может разделять единый брендовый контур на несколько сущностей, смешивать связанные названия или не понимать, где заканчивается холдинг и начинается отдельная клиника. При этом размер бизнеса сам по себе не спасает от такой путаницы.
Пять типов путаницы, которые особенно опасны для бренда
1. Совпадение названия: «это вообще другая компания»
Самый простой и самый показательный сценарий. Короткое название, международное слово или аббревиатура существует сразу в нескольких отраслях. Если контекста запроса мало, поисковый слой может вернуть более сильную или более популярную сущность. Затем генеративная модель соединит ее с правильной темой. Именно так возникает эффект «правильные слова, неправильный бренд».
Пример из массива: ORIS в автомобильном контексте и Oris в часовом. Риск выше, когда у более известного одноименного бренда больше упоминаний, каталогов и внешних страниц.
2. Бренд, юрлицо и дистрибьютор превращаются в одну сущность
На сайтах компаний часто одновременно встречаются торговая марка, название юридического лица, группа компаний, производитель и дистрибьютор. Для человека эти связи очевидны из контекста. Для машины они становятся отдельной задачей entity resolution: какие названия являются синонимами, какие – связаны, а какие – конкурируют.
Если разные площадки называют один и тот же продукт разными компаниями, AI может перенести свойства производителя на продавца или наоборот.
3. Старое и новое название живут параллельно
Ребрендинг, смена владельца или юридического лица часто оставляют в интернете два слоя информации. Старые каталоги, отзывы и публикации продолжают индексироваться; новый сайт рассказывает уже другую историю. Для генеративного поиска это может выглядеть как две независимые сущности либо как одна компания с противоречащими друг другу фактами.
Особенно опасны несинхронизированные страницы «О компании», карточки в каталогах и публикации с устаревшей географией или составом услуг.
4. География «протекает» между сущностями
Если у бренда есть представительства, дилеры, партнеры или одноименные компании в разных городах и странах, географический атрибут легко становится источником ошибки. AI может корректно распознать название, но приписать ему адрес, рынок или страну другой сущности.
Для локального бизнеса такая ошибка критична: пользователь получает рекомендацию компании, которая формально существует, но не обслуживает его регион.
5. Репутационные сигналы переносятся не тому бренду
Отзывы, рейтинги и обсуждения особенно плохо терпят неоднозначность. Если карточки на внешних площадках собраны вокруг похожего названия, негатив или позитив одной компании может попасть в контекст другой. В обычном поиске пользователь еще может увидеть несоответствие по логотипу и адресу. В AI-ответе репутационный вывод уже может быть сформулирован как готовое суждение.
Поэтому для бренда риск – не только потерять рекомендацию, но и получить чужую репутацию.
Почему наличие ссылок не гарантирует, что ошибка исчезнет
Распространенная интуиция звучит так: если AI использует веб-поиск и показывает источники, проблема галлюцинаций почти решена. На практике retrieval снижает риск, но не устраняет задачу сопоставления сущностей. Модель все равно должна понять, какой найденный документ относится к какому бренду и какие атрибуты можно переносить в итоговый ответ.
OpenAI прямо описывает, что ChatGPT Search может преобразовывать пользовательский вопрос в один или несколько поисковых запросов и затем использовать найденные веб-источники. Это повышает актуальность, но означает, что качество ответа зависит не только от генерации, но и от формулировки поискового запроса, состава найденных кандидатов и последующего сопоставления документов с сущностями.
Исследования RAG также рассматривают retrieval, augmentation и generation как отдельные этапы, каждый из которых может вносить собственную ошибку. А работы по entity alignment отдельно используют многораундовое голосование именно для снижения галлюцинаций и позиционного смещения при сопоставлении сущностей. Для маркетинга отсюда следует важный вывод: AI-ошибка может возникать раньше, чем модель начинает писать ответ.
Какие бренды находятся в зоне повышенного риска
|
Сигнал риска |
Почему это сложно для AI |
Что проверить |
|
Короткое или общеупотребительное название |
Много одноименных сущностей и слабый контекст |
Добавлять отрасль, географию и полное имя бренда в ключевых страницах |
|
Название совпадает с международным брендом |
Более сильная глобальная сущность может вытеснять локальную |
Проверить AI-ответы на брендовых и категорийных запросах |
|
Несколько юрлиц / суббрендов |
Неочевидно, какие сущности являются одной системой |
Опубликовать ясную карту связей «бренд – компания – продукт – регион» |
|
Ребрендинг или старое название |
В интернете одновременно живут противоречивые версии |
Синхронизировать старые карточки, каталоги и внешние публикации |
|
Разные написания и транслитерации |
Система может разделить одно имя на несколько сущностей |
Закрепить каноническое написание и допустимые варианты |
|
Слабый официальный сайт |
AI вынужден достраивать факты по посредникам |
Создать страницы с конкретными фактами, датами, адресами, продуктами и связями |
Как измерять путаницу бренда, а не только «видимость»
Для диагностики AI Visibility полезно добавить к обычной доле упоминаний отдельный слой entity-quality. Например:
-
Entity Consistency Rate: доля ответов, где название, компания, продукт и география согласованы между собой;
-
Source Purity: доля видимых источников, которые действительно относятся к нужной сущности;
-
Attribute Leakage Rate: частота переноса атрибутов – продуктов, адресов, отзывов, наград – от другой компании;
-
Brand Fragmentation: сколько отдельных сущностей AI создает из одного брендового контура;
-
Repeat Stability: насколько один и тот же бренд сохраняет идентичность при повторных формулировках вопроса.
Это меняет сам предмет измерения. В классическом SEO мы спрашиваем: «видит ли поисковик страницу и на какой позиции она ранжируется?». В AI Search появляется дополнительный вопрос: «понимает ли система, что все эти страницы относятся к одной и той же компании – и не смешивает ли ее с соседней сущностью?»
Что бизнесу делать уже сейчас: семь практических шагов
-
Собрать «паспорт сущности»: каноническое название, старые названия, транслитерации, юрлицо, домен, география, продукты, суббренды и связь между ними.
-
Сделать официальный сайт источником однозначных фактов. Страница «О компании» должна отвечать не маркетинговыми лозунгами, а конкретикой: кто вы, где работаете, что производите, как связаны бренды и компании.
-
Добавлять контекст к короткому брендовому имени. Если название неоднозначно, отрасль и география должны регулярно присутствовать в title, описаниях, карточках компании и внешних профилях – без переспама.
-
Провести ревизию внешних площадок: каталоги, карты, маркетплейсы, рейтинги, СМИ и отраслевые базы. Ошибка на чужой странице может попасть в AI-ответ даже при идеальном корпоративном сайте.
-
Не удалять историю ребрендинга из публичного поля. Лучше явно связать старое и новое название, чем оставлять AI самому угадывать, одна это компания или две.
-
Тестировать не один «идеальный» брендовый запрос, а набор реальных пользовательских сценариев: «что выбрать», «отзывы», «кто производитель», «где находится», «чем отличается», «кто владелец», «подходит ли для…».
-
Вести журнал AI-ошибок. Для каждой – запрос, система, дата, неверный атрибут, источник ошибки и исправленное цифровое доказательство. Так entity management становится постоянным процессом, а не разовой кампанией.
Что это меняет для SEO, PR и управления репутацией
Генеративный поиск сближает дисциплины, которые раньше жили отдельно. SEO отвечало за страницы и спрос, PR – за внешние упоминания, ORM – за отзывы, бренд-команда – за архитектуру названий. Для AI-системы все это становится одним графом доказательств о сущности.
Если в этом графе противоречия, модель не обязана выбрать «официальную» версию. Она может собрать наиболее доступную и правдоподобную комбинацию. Поэтому конкурентоспособность в AI Search зависит не только от количества контента, но и от его согласованности.
Новая задача – не просто занять место в ответе AI, а добиться того, чтобы AI стабильно понимал, кого именно он рекомендует.
Вывод
Путаница брендов – не редкая «галлюцинация из воздуха», а закономерный класс ошибок на стыке поиска, извлечения источников и сопоставления сущностей. В нашем исследовательском массиве нерелевантные или неоднозначные домены встретились в 4 из 35 ответов с видимыми источниками. Это слишком небольшая выборка для универсальной оценки всех AI-систем, но достаточный сигнал, чтобы бизнес относился к entity clarity как к отдельной задаче.
Особенно уязвимы компании с короткими названиями, совпадениями с международными брендами, сложной архитектурой юрлиц, ребрендингами и несогласованными внешними карточками. Для них рост AI Visibility без контроля сущности может даже усилить проблему: бренд будет появляться чаще – но не всегда в правильном контексте.
Поэтому следующий вопрос после «рекомендует ли нас нейросеть?» должен звучать так: «уверена ли она, что рекомендует именно нас?»
Методологические ограничения
Исследование отражает конкретные ответы в выбранных интерфейсах и сценариях на дату замера. 11,4% рассчитаны только по 35 ответам, где были видимы URL, и относятся к наблюдаемому источниковому слою одной товарной категории. Это не частота всех ошибок, не рейтинг платформ и не оценка точности на всем российском рынке.
В некоторых системах прямые URL в интерфейсе не отображались, поэтому отсутствие видимой ссылки нельзя трактовать как отсутствие внешней информации. Один ответ на пару «платформа – сценарий» также не измеряет устойчивость платформы. Для полноценного отраслевого бенчмарка нужны повторные прогоны, контролируемый набор одноименных брендов, единый режим веб-поиска и ручная верификация атрибутов по первичным источникам.

Подписывайся!
 ВКонтакте
Есть о чем рассказать? Тогда присылайте свои материалы Марине Ибушевой