Начало начал и основа основ: секреты парсинга

Данная статья написана по следам воркшопа «Начало начал и основа основ – секреты парсинга» от Сергея Горобий, руководителя отдела аналитики SEOWORK.
Что это такое и зачем? Парсинг vs Скрапинг vs Краулинг
Парсинг – это структуризация и синтаксический разбор неструктурированных данных. Краулинг – это обход страниц сайта и сбор неструктурированных данных. Скрапинг – объединяет в себе первые 2 понятия: это и обход ссылок, и сбор данных, а также разбор и структуризация.
В SEOWORK вы можете встретить парсинг при сборе:
- частотности запросов (парсинг Wordstat);
- поисковой выдачи (мы забираем данные про сниппеты, колдунщики, все данные про органику и контекстную рекламу);
- слепков HTML и их разбора в «Аналитике»;
- данных в «Тех мониторе»;
- результатов для большинства «инструментов»;
- данных с внешних источников (системы аналитики, Вебмастера и т. д.);
- данных для создания сегментов.
Как можно парсить данные?
Вручную в браузере. Вы можете использовать для этого расширения, такие как Scraper, Data Scraper. Этот способ подходит для небольшого количества страниц.
Используя десктопные приложения. Для 1000 и более страниц помогут инструменты Screaming Frog, A-Parser, Content Downloader.
С помощью надстройки в Excel (ParserOK).
Прямым парсингом в Google Таблицы (функции IMPORTXML и IMPORTHTML).
И еще много других способов и парсеров (см. статью).
Синтаксический анализ HTML
Когда мы парсим данные, зачастую нам не требуется забирать весь HTML со всей структурой и разбирать его целиком. На стартовом этапе мы хотим забрать определенные данные из каких-то определенных зон документа и в этом нам помогают селекторы. Они обращаются к конкретной зоне и адресу структуры и забирают только нужные нам данные.
1. Самые популярный – CSS selector (CSSPath)
CSSPath = ‘html > body > span:nth-of-type(1) a’
За счет прописанных стилей селектор выбирает нужные блоки из структуры документа и уже с них забирает данные.
2. Xpath selector (удобное расширение для браузера)
Xpath = ‘html/body/span[1]//a’
Изначально использовался для xml, но также актуален и для html-структуры. В отличии от CSS-селектора он может обращаться в глубину и обратно – можно провалиться в родительскую ноду/элемент и после вернуться обратно. Он предпочтительнее, так как это передвижение по осям закрывает множество потребностей для парсинга.
3. jQuery selector
XPath
Работать с XPath можно через copy XPath непосредственно через интерфейс браузера, но лучше прописывать путь XPath самостоятельно. Казалось бы, что копировать путь – достаточно для получения необходимых данных, но как показывает практика, без синтаксиса все равно не обойтись.
Поэтому давайте разберем синтаксис XPath подробнее.
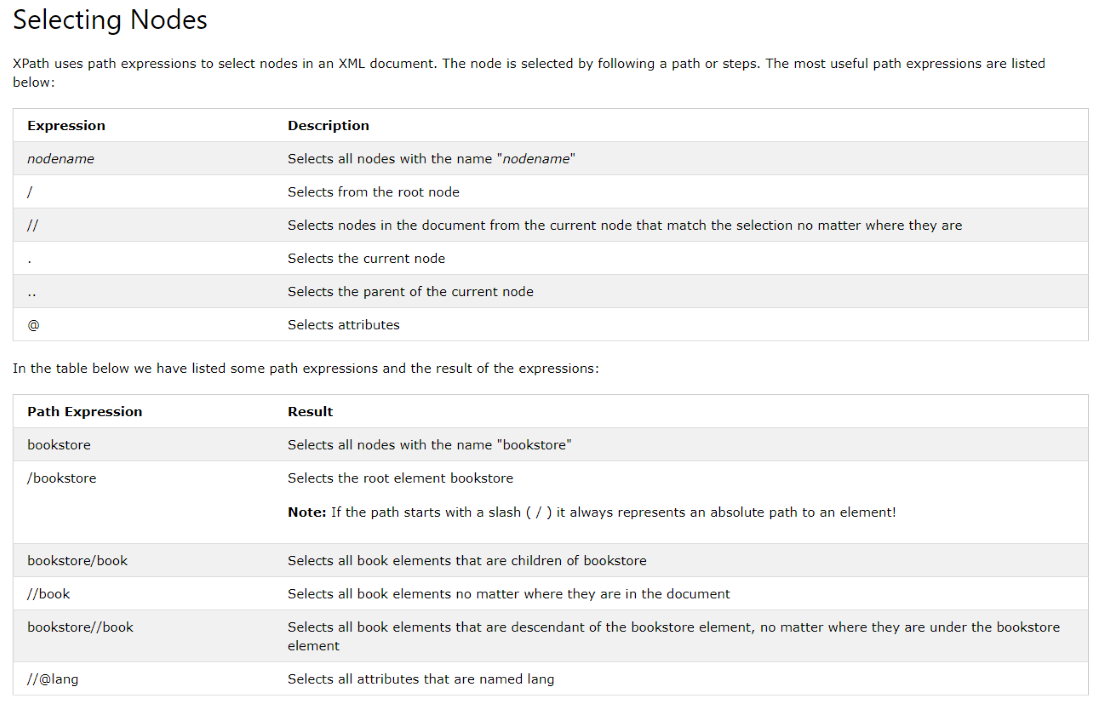
Для работы с XPath мы используем ноды (ссылка):
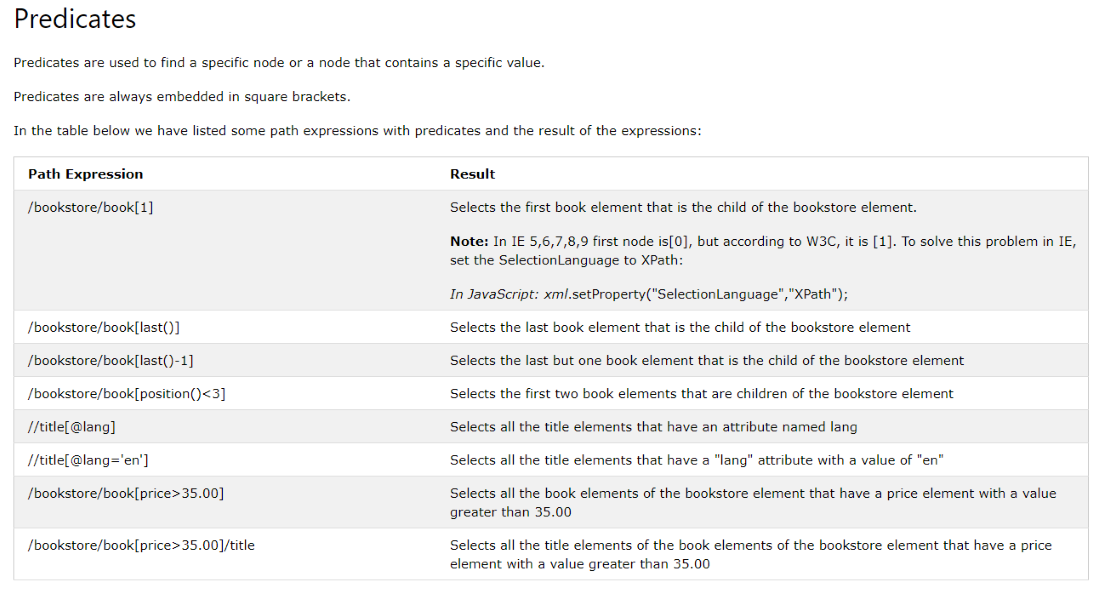
предикаты (ссылка):
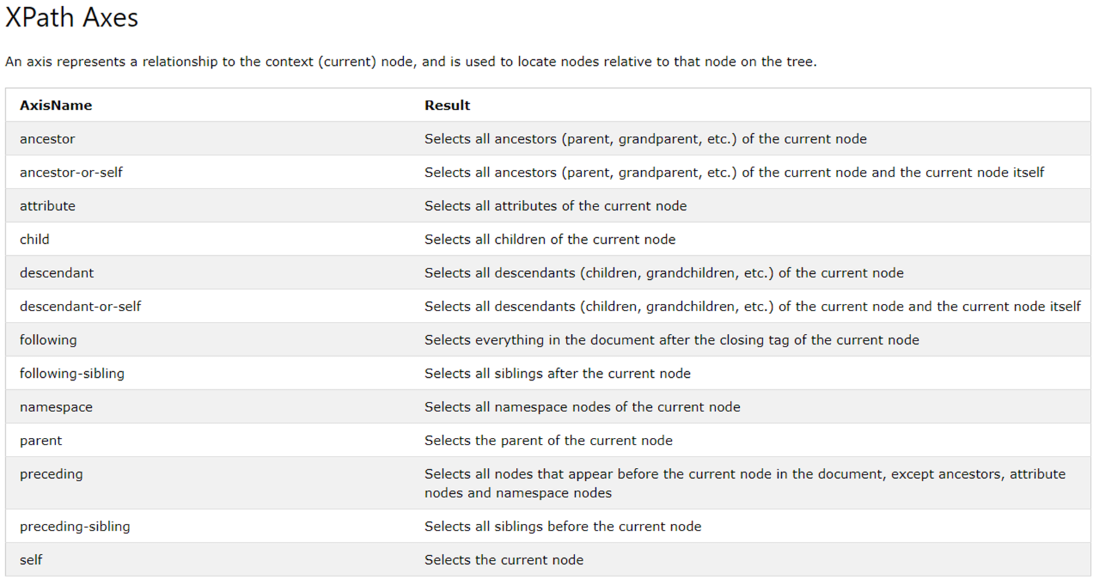
Оси (ссылка):
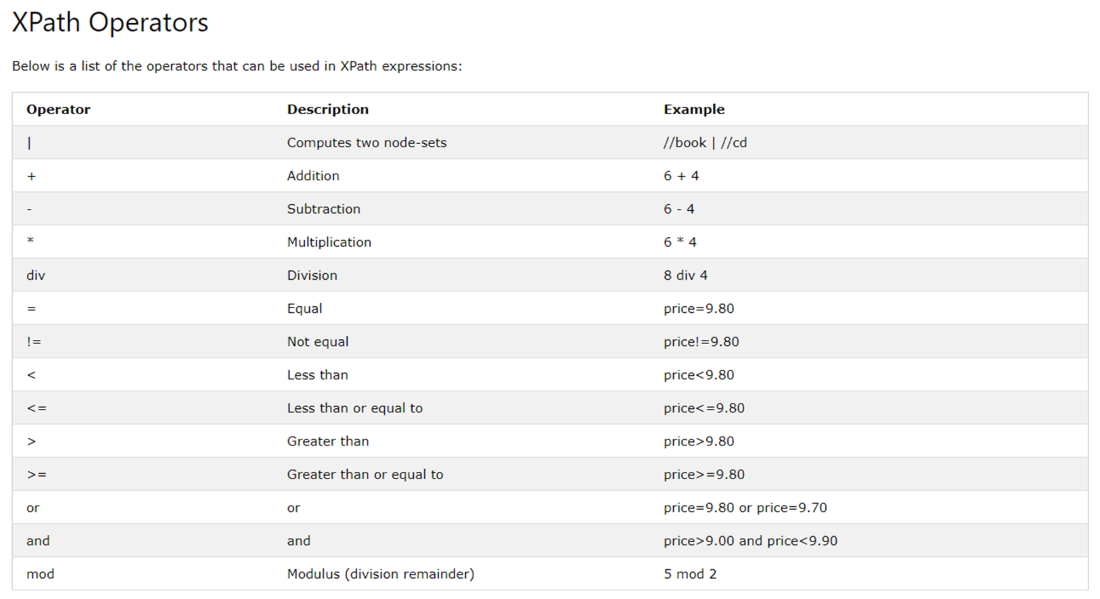
а также операторы (ссылка):
Функции
Облегчить работу с данными можно еще на этапе подготовки к парсингу, используя функции XPath.
Основные полезные функции:
- count(),
- last() / position(),
- string-length(),
- contains(),
- starts-with() или ends-with(),
- boolean(),
- substring-before() или substring-after(),
- normalize-space().
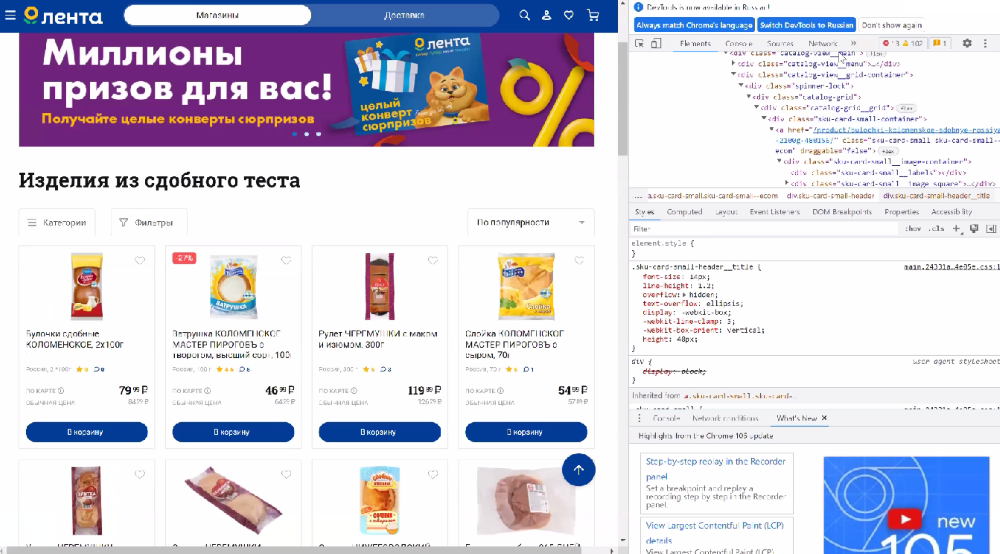
Задача #1. Собрать с листинга все ссылки на товары, которые стоят больше 50 руб.
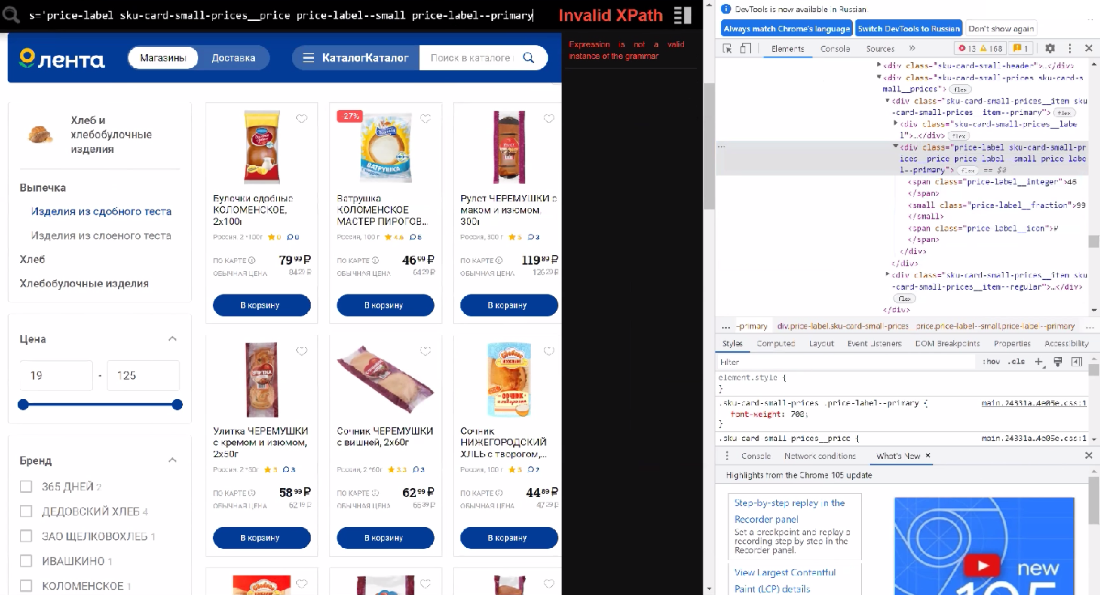
Сразу на странице мы находим лейб цены и обращаемся к этому графу. Нам интересны только целочисленные значения, выбираем их через span и обозначаем позицию предикатом.
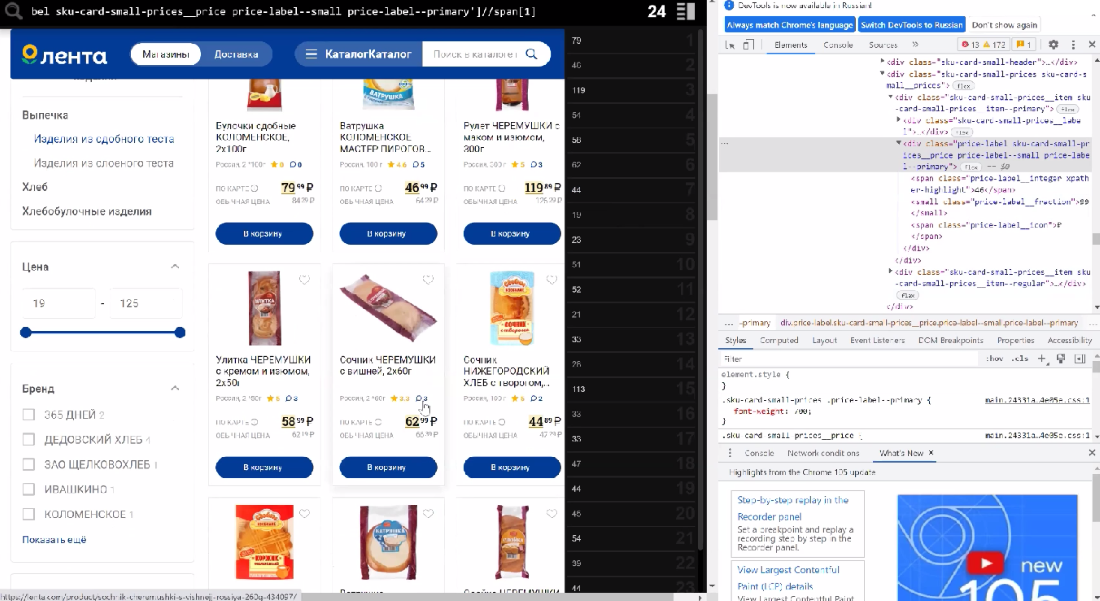
И тут же мы можем ограничить вывод данных через какое-то условие, например, больше 50 руб. Обращаемся к ноде через точку и задаем условие.
Страница, на которой работал: https://lenta.com/catalog/hleb-i-hlebobulochnye-izdeliya/vypechka/izdeliya-iz-sdobnogo-testa/
Xpath //div[@class='price-label sku-card-small-prices__price price-label--small price-label--primary']//span[1][.>50]
Как вы видите, в out выводятся пока только числа. Как достать ссылки товаров? Обратимся к структуре и увидим, что ссылка находится по структуре выше, чем div.
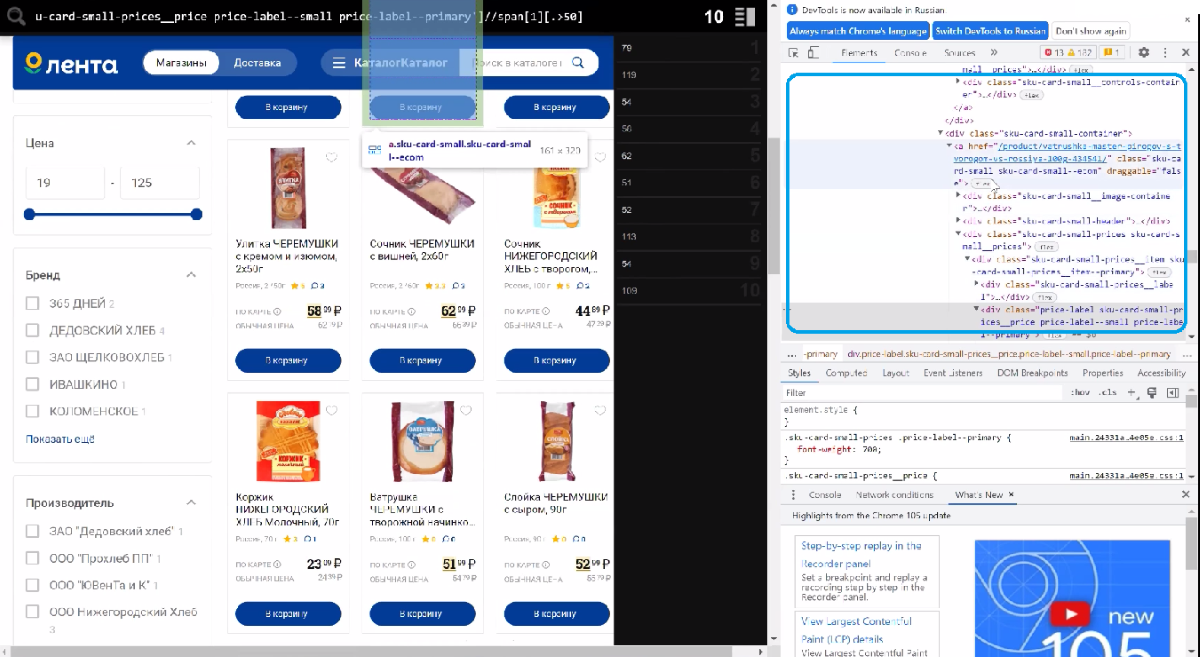
То есть наша цена вложена в эту ссылку, и так как мы используем XPath, мы можем перемещаться по оси вверх и вниз. Обратимся к элементу предку, используем ось ancestor и забираем атрибутом href у элементов a.
В результате для страницы: https://lenta.com/catalog/hleb-i-hlebobulochnye-izdeliya/vypechka/izdeliya-iz-sdobnogo-testa/ получаем Xpath
//div[@class='price-label sku-card-small-prices__price price-label--small price-label--primary']//span[1][.>50]//ancestor::a/@href
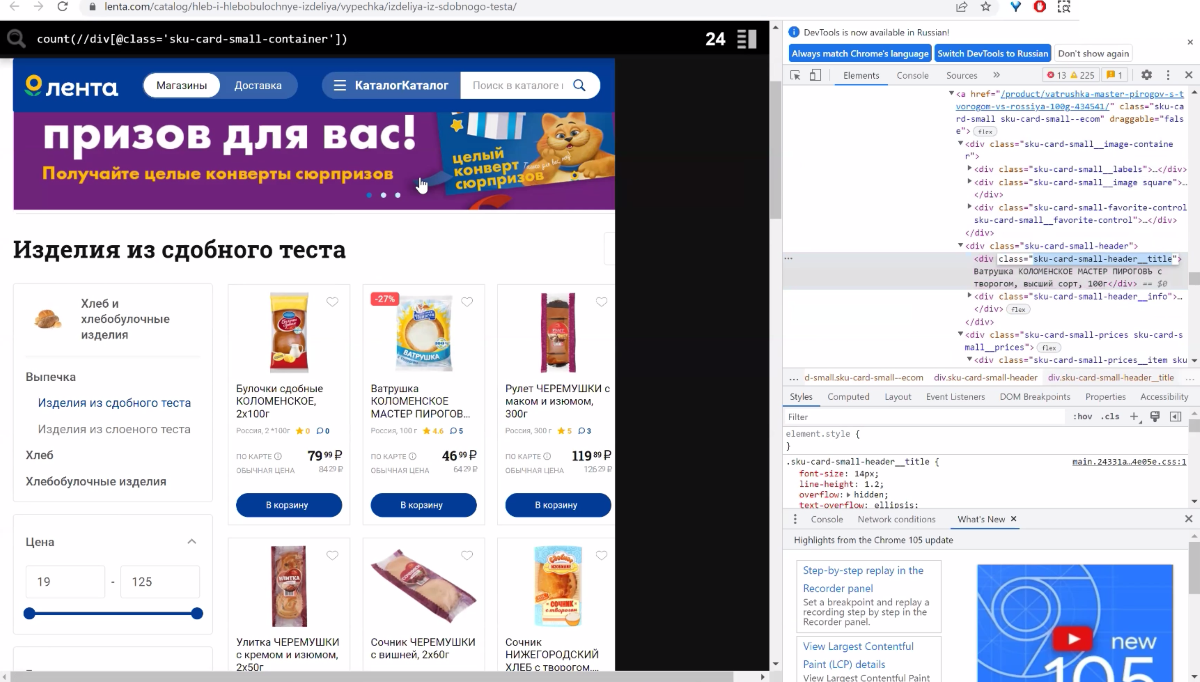
Задача #2. Подсчет количества товара на странице
Разберем функцию “count” – функция подсчета. Например, мы выбрали все товары на странице и хотим посчитать их количество на странице.
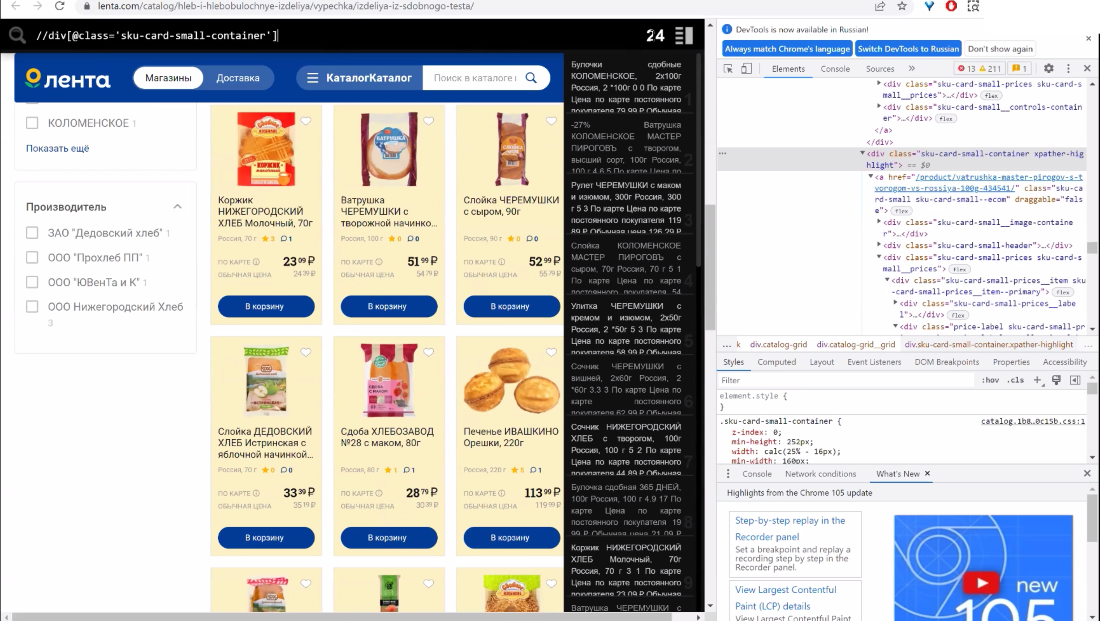
В итоговом файле у нас будут только все текстовые значения, которые выведены в блоке справа, а мы хотим получить именно цифровое значение. Поэтому прописываем функцию count и получаем нужное нам значение количества.
Страница, на которой работал: https://lenta.com/catalog/hleb-i-hlebobulochnye-izdeliya/vypechka/izdeliya-iz-sdobnogo-testa/
Xpath: count(//div[@class='sku-card-small-container'])
Задача #3. Как посчитать количество символов в статье
Находим в структуре элемент, в котором располагается вся статья, в нашем случае обращаемся к div с атрибутом itemprop со значением articleBody.
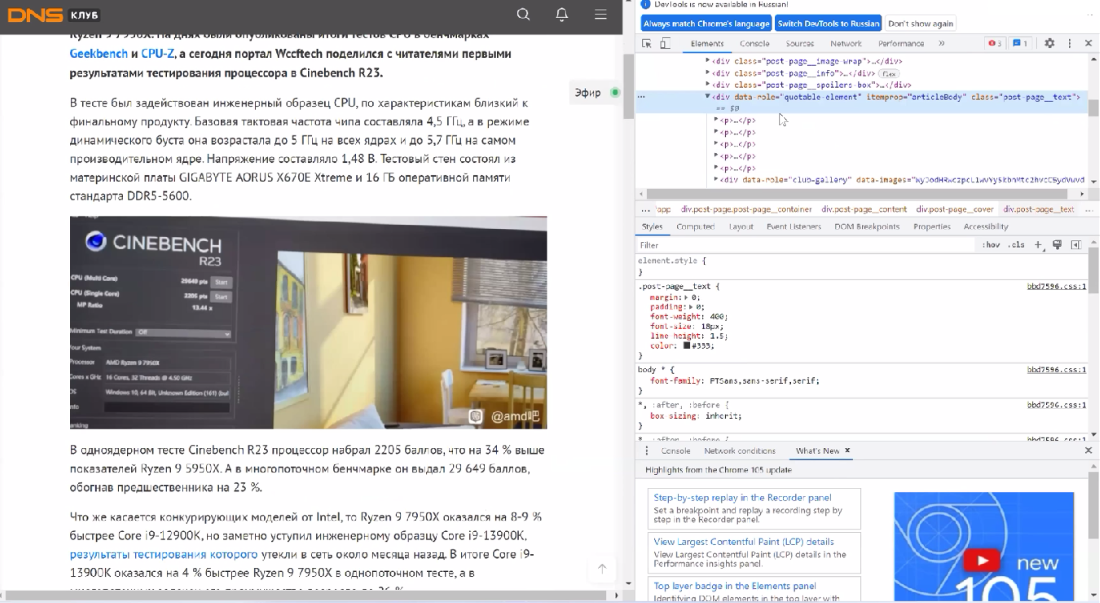
Выделили в граф весь текст статьи и переходим к подсчету количества символов, используя функцию string-length.
Страница, на которой работал: https://club.dns-shop.ru/digest/78762-ryzen-9-7950x-okazalsya-do-26-medlennee-core-i9-13900k-v-cinebe/
Xpath: string-length(//div[@itemprop='articleBody'])
Задача #4. Собрать все ссылки на один тип товара/страницы с общей страницы витрины/листинга
Следующая полезная функция – contains. По ней можно находить различные элементы, которые содержат, например, определенный текст. Разберем на примере Окко.
У нас есть страница-коллекция, и мы хотим забрать с нее все линки карточек фильмов, не затрагивая карточки, в которых располагаются сериалы.
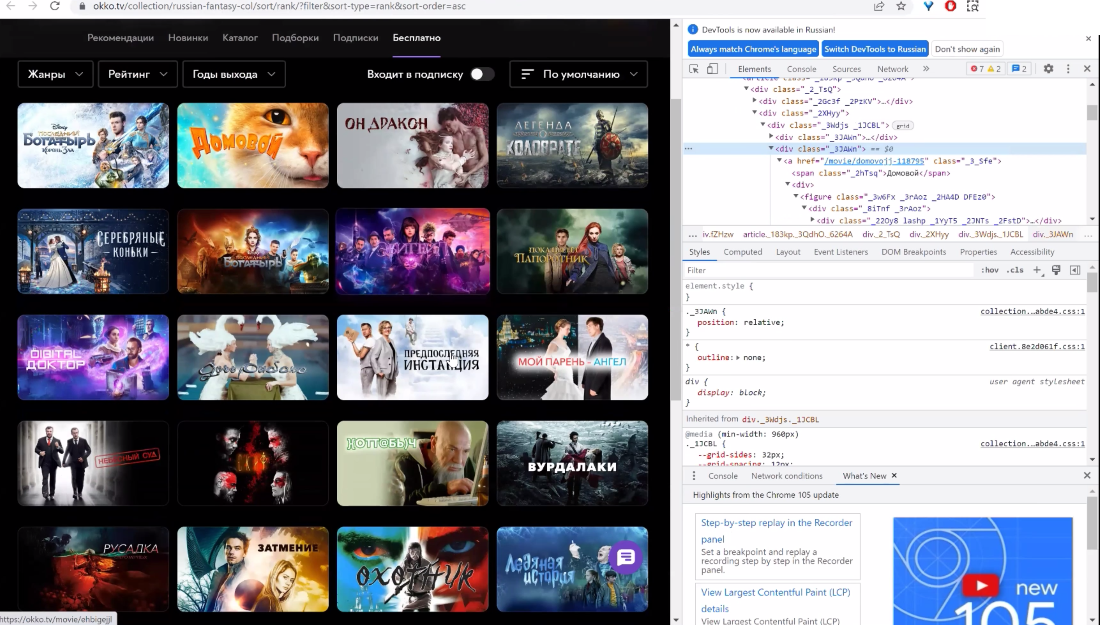
Для начала обратимся к графу всех карточек в верхнем уровне, выбираем этот граф. Получилось 20 карточек (отмечаем, что есть url двух структур – movie и serial, по ним и будем разграничивать фильмы и сериалы). После чего обращаемся к линкам и задаем нужные условия (фильтрация по movie).
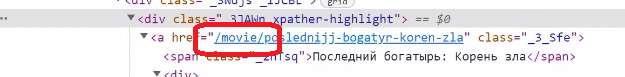
Страница: https://okko.tv/collection/russian-fantasy-col
Получаем: //div[@class='_3JAWn']//a[contains(@href, '/movie/')]/@href
По итогу видим, что в выборке остается 16 карточек фильмов.
Задача #5. Фильтрация по тексту
Также можно обращаться просто к анкору ссылки. Тут мы найдем пример на сайте Ленты.
Страница: https://lenta.com/catalog/hleb-i-hlebobulochnye-izdeliya/vypechka/izdeliya-iz-sdobnogo-testa/
Найдем на листинге div с названием карточек и отфильтруем по названию. Прописываем «A»-предикат, через точку обращаемся к самой ноде и уже тут задаем, какое название нам необходимо, например, «Ватрушка».
//div[@class='sku-card-small-header__title'][contains(. , Ватрушка)]
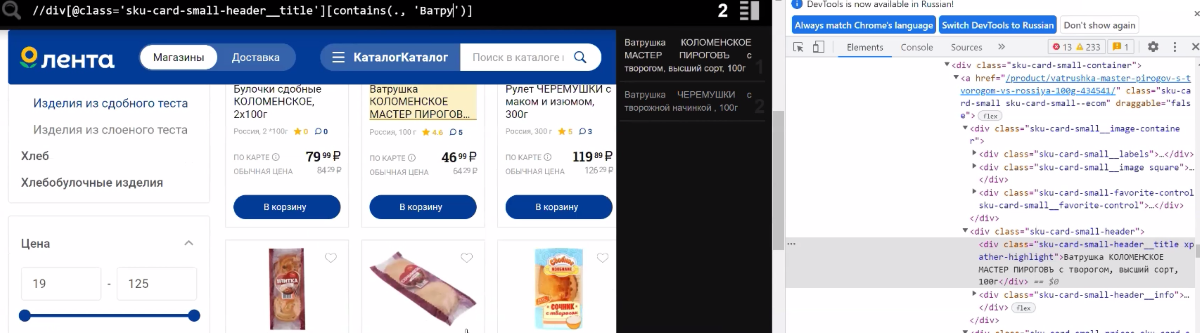
Находим 2 подходящих товара.
Задача #6. Поиск элементов, которые начинаются или заканчиваются с нужного значения
Дальше остановимся на функции starts-with() или ends-with(). На примере, который мы рассматривали на сайте Окко, мы можем заменить функцию contains и задать starts-with. Это будет означать, что строка должна начинаться с movie.
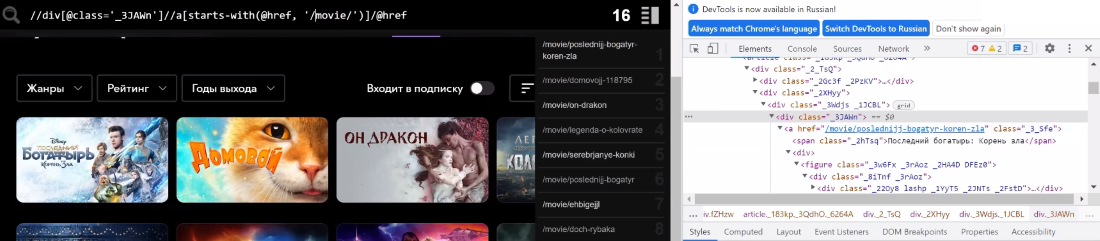
Страница: https://okko.tv/collection/russian-fantasy-col
Получаем: //div[@class='_3JAWn']//a[starts-with(@href, '/movie/')]/@href
Задача #7. Дублируются ли заголовки H1 на странице?
Функция boolean отдает бинарное значение true/false на заданное нами условие. Например, есть задача найти страницы, где могут дублироваться несколько H1. Если вы нашли их на какой-то странице и хотите убедиться, что на других страницах сайта такой проблемы нет – это легко сделать через функцию boolean.
Прописываем условия, что на странице более 1 заголовка H1, и на выходе получаем false или true.
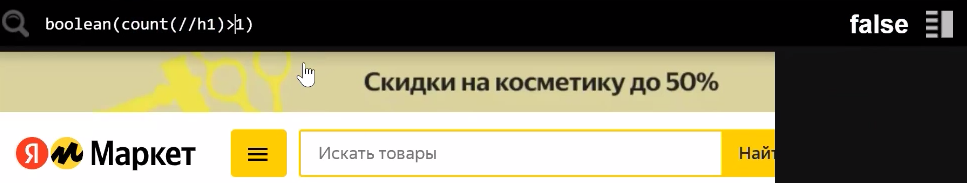
Страница: https://market.yandex.ru/catalog--noutbuki/54544/list
Получаем: boolean(count(//h1)>1)
Если на странице H1 не дублируется и только один, то в out мы будем получать false. Если же H1 на странице несколько, то в out мы получим true.
Задача #8. Узнать количество товаров на листинге + отсекаем текст
Чтобы узнать количество товаров на листинге, когда нет возможности посчитать все товары в категории (например, много страниц пагинации), можно воспользоваться лайфхаком и найти значение количества товаров на первой странице листинга. В нашем кейсе мы нашли это значение под всеми фильтрами. Видим, что в категории конструкторы – 9526 товаров. Можем достать Xpath этого элемента.
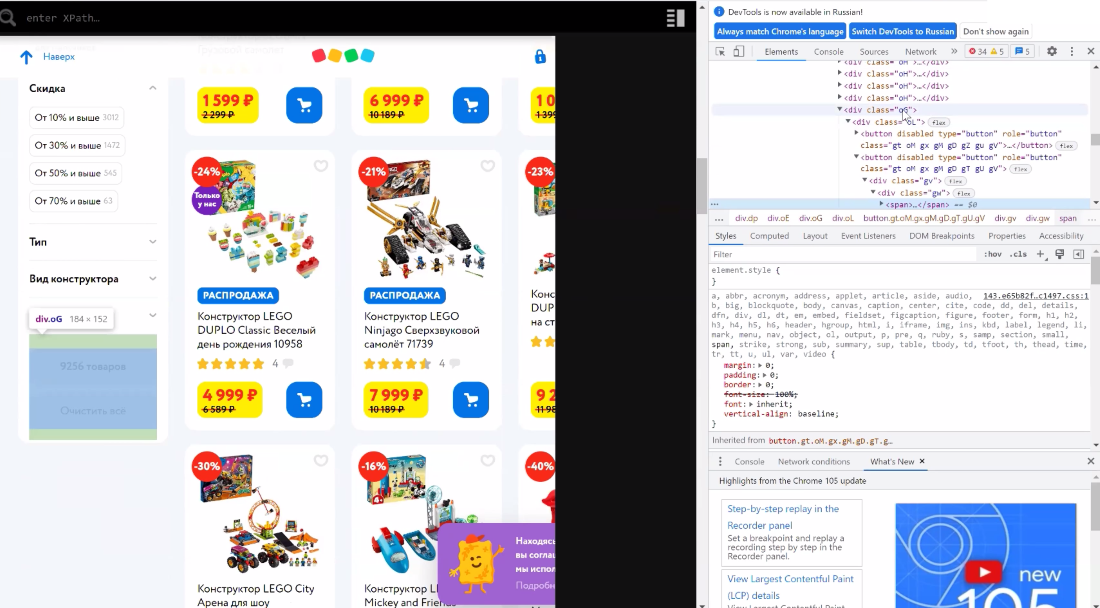
Страница: https://www.detmir.ru/catalog/index/name/konstruktory/
Xpath: //div[@class='wQ']//button[2]
Но мы видим в нашем out текст «9526 товаров». Воспользовавшись функцией substring-before(), мы можем отсечь значение “ товаров” и в out получим только число 9526.
Страница: https://www.detmir.ru/catalog/index/name/konstruktory/
Xpath: substring-before(//div[@class='wQ']//button[2], ' товаров') //итоговый запрос//
Задача #9. Как собрать значения без лишних пробелов?
Например, мы планируем спарсить все H1, но откуда-то появились странные пробелы. Исправить ситуацию быстро можно функцией normalize-space().
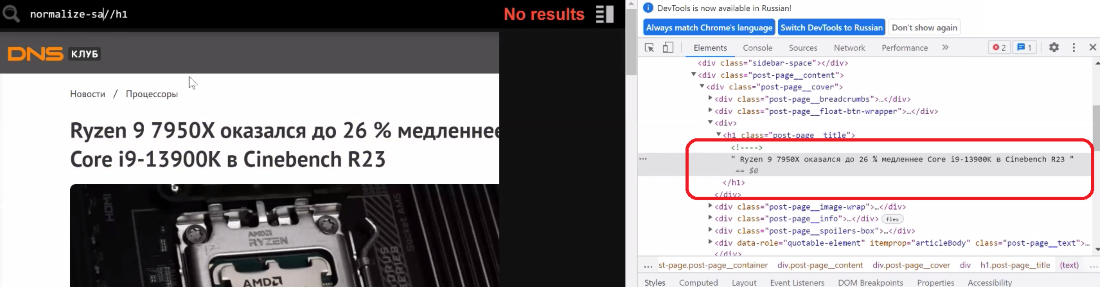
Для этого прописываем xpath normalize-space(//h1).
Задача №10. Как собрать ссылки на изображения?
На примере МВидео соберем ссылки на все изображения с листинга. Находим необходимый DIV на странице, настраиваем фильтрацию по размеру картинки и на выходе получаем весь список картинок.
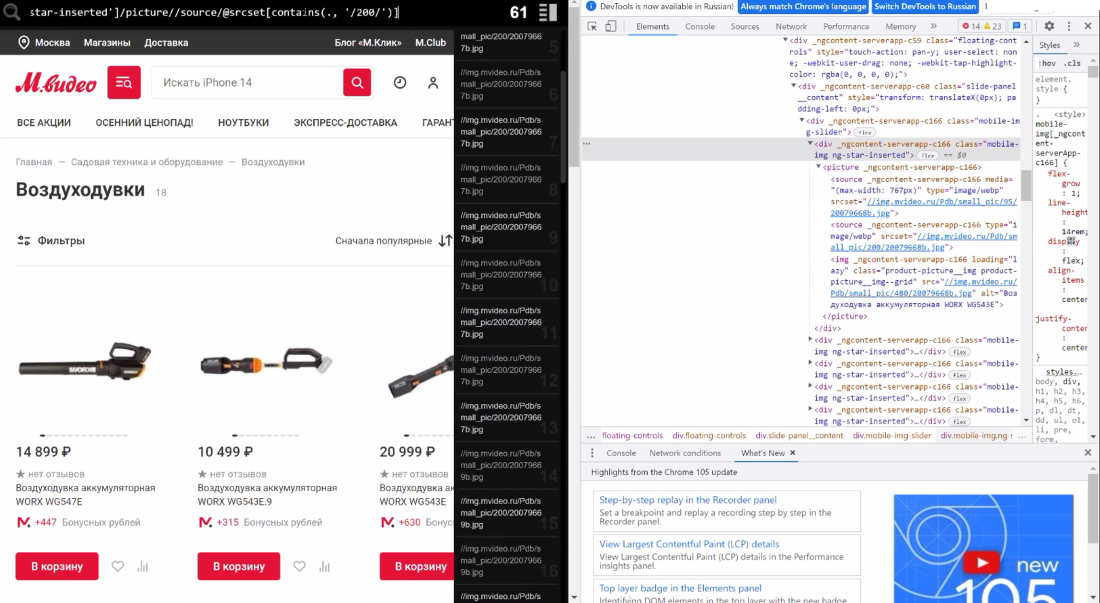
Страница, на которой работал: https://www.mvideo.ru/sadovaya-tehnika-i-oborudovanie-8027/vozduhoduvki-9489
Xpath //div[@class='mobile-img ng-star-inserted']//picture//source/@srcset[contains(., '/200/')]
и //div[@class='mobile-img ng-star-inserted']//picture//img/@src
Еще больше примеров работы с XPath вы узнаете из воркшопа «Начало начал и основа основ – секреты парсинга».

Подписывайся!
 ВКонтакте
Есть о чем рассказать? Тогда присылайте свои материалы Марине Ибушевой