Кластеризация семантики через нейросети: как сделать и сколько это стоит
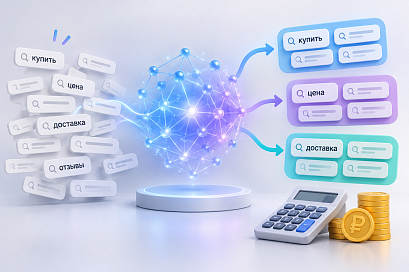
Нейросети предлагают другой путь: группировать запросы по смыслу. Ниже – пошаговый алгоритм, как это сделать, что делать с запросами, которые модель отсеяла, как проверить качество, и отдельно – сколько это стоит по актуальным прайсам. Сразу оговорюсь: это методика и расчет, а не отчет о проекте. Тестовый набор – 40 запросов о кондиционерах, которые я составил сам.
Почему не стоит просто вставлять список в чат
Первое, что приходит в голову, – скопировать семантику в чат и попросить разбить ее на группы. На сотне запросов это даже работает. На десяти тысячах – нет, и дело не в цене.
Посмотрим на токены. В моем наборе русский запрос вместе с номером строки занимает в среднем 10,7 токена в токенизаторе o200k_base, которым OpenAI размечает текст для моделей последних поколений. Десять тысяч запросов – около 107 тысяч токенов на входе. Но модель должна вернуть каждый запрос с меткой кластера, а это уже около 147 тысяч токенов на выходе. У GPT-6 Luna, например, потолок ответа – 128 тысяч токенов. Ответ просто не поместится, и модель либо оборвет его, либо начнет «экономить»: пропускать запросы, склеивать похожие, исправлять опечатки. Каждое такое исправление ломает сопоставление с частотностью.
При этом по деньгам такой запрос стоит копейки: около 137 рублей на GPT-6.1 Sol и около 7 рублей на GPT-6 Luna. Проблема в том, что результат невозможно проверить, кроме как перечитав все руками. Поэтому ниже – схема, где языковая модель появляется только на проверке уже готовых групп.
С чего начать: пошаговый алгоритм
Я разделяю задачу на семь шагов. Языковая модель нужна только на четвертом. Можно идти по чек-листу сверху вниз.
1. Входные данные. Список запросов в формате id< TAB >запрос. У каждого запроса уникальный числовой id. Частотность и URL посадочных на этом этапе не обязательны – они пригодятся при сверке и при выборе названия кластера. Не отдавайте модели сырой список без id: иначе она начнет переписывать фразы, и сопоставление с исходной семантикой развалится.
2. Эмбеддинги. Каждый запрос превращается в вектор, отражающий его смысл. Это делает отдельная модель, не языковая. text-embedding-3-small у OpenAI стоит $0,02 за миллион токенов. Эти модели используют токенизатор cl100k_base, и в нем русский запрос из моего набора весит в среднем 15,2 токена. Десять тысяч запросов – около 152 тысяч токенов, или примерно 25 копеек по курсу ЦБ на 23 октября (81,13 ₽ за доллар). Старшая text-embedding-3-large обойдется в 1,6 рубля. Gemini Embedding 2 у Google стоит $0,20 за миллион текстовых токенов, но токенизатор у нее свой, так что точное число я не назову, порядок тот же – рубли.
3. Кластеризация алгоритмом и порог. Векторы группируются по косинусному расстоянию, например агломеративной кластеризацией. Это бесплатно, считается на ноутбуке и воспроизводимо: те же векторы и тот же порог всегда дают те же группы. Главный параметр – порог расстояния. Подбирайте его под тематику: слишком низкий – размажет близкие синонимы по разным группам, слишком высокий – склеит услуги, товары и информационные запросы в один ком. Начните с одного порога, посмотрите на размер кластеров и долю одиночек, затем сдвиньте порог и сравните.
4. Проверка каждого кластера языковой моделью. Модель получает не всю семантику, а одну группу на 10–15 запросов и отвечает на конкретные вопросы: одна ли это посадочная страница, какой интент, какие запросы лишние (outliers), как назвать группу. Промпт, который я использую:
Ты проверяешь кластер поисковых запросов для SEO. Тематика сайта: {тематика}. Регион: {регион}.
На вход – список запросов в формате «id< TAB >запрос». Все запросы уже сгруппированы алгоритмом по смыслу,
твоя задача – проверить группу, а не придумать новую.
Правила:
1. Один кластер = одна посадочная страница. Если запросы требуют разных страниц (покупка товара и заказ услуги, инструкция «своими руками» и коммерческая страница, разные бренды, разные города), это разные кластеры.
2. Определи основной интент кластера: commercial, informational, navigational или mixed.
3. Перечисли id запросов, которые не подходят к основной группе, и коротко объясни почему.
4. Предложи название кластера: 2–5 слов, на основе самого частотного или самого общего запроса группы.
5. Не исправляй опечатки и не переписывай запросы. Не добавляй запросы, которых нет во входных данных.
Работай только с id.
6. Если не уверен, ставь "confidence": "low" – такие кластеры проверит человек.
Ответ строго в JSON: {"name": str, "intent": str, "outliers": [{"id": int, "reason": str}], "confidence": str}
Ключевое здесь – работа через id. Модель не пересказывает запросы, а только ссылается на номера, поэтому переписать или потерять фразу она не может физически, а лишний id легко отловить кодом.
5. Outliers. Запросы, которые модель сочла лишними, не выкидывайте и не оставляйте «висеть» без кластера. Раздел ниже – куда их девать и когда повторять прогон.
6. Сверка с выдачей. Крупные коммерческие кластеры, группы с confidence: low, все с интентом mixed и спорные outliers проверяйте по топу. Так кластеризация по выдаче остается, но применяется к сотне спорных групп, а не к десяти тысячам запросов. Сколько стоит съем выдачи, зависит от сервиса, и в расчет цен ниже я его не включаю.
7. Проверки кодом. После каждого прогона сверяйте: каждый id из входных данных встречается ровно в одном кластере; в ответах нет id, которых не было на входе; JSON разбирается. Если хотя бы одна проверка не прошла, кластер отправляется на повтор или человеку. Это три строчки на Python, которые экономят часы.
Что делать с outliers
Outlier – запрос, который алгоритм положил в группу, а языковая модель при проверке отметила как чужой. В JSON он лежит в массиве outliers вместе с короткой причиной. Варианты, что с ним делать:
|
Решение |
Когда уместно |
Что делать дальше |
|---|---|---|
|
В другой существующий кластер |
Причина указывает на соседнюю группу (другой бренд, другая услуга, тот же товар) |
Перенести id вручную или скриптом; при сомнении – повторная LLM-проверка уже новой группы |
|
Новый кластер |
Outlier один или несколько похожих друг на друга, и под них нужна отдельная посадочная |
Собрать их в отдельную группу, прогнать через тот же промпт |
|
Ручная проверка |
confidence: low, причина размытая, или запрос на стыке интентов |
Смотрит специалист; при коммерческом весе – сверка с топом |
|
Отложить |
Низкая частотность, служебный хвост, явный мусор |
Пометить в отдельный список «вне кластеров», не смешивать с рабочими группами |
Когда повторять прогон. Если из кластера выпало больше трети запросов – порог или первичная группировка, скорее всего, ошиблись: имеет смысл сдвинуть порог и пересчитать этот участок, а не разносить outliers руками по одному. Если outliers единичные и причины конкретные («другой бренд», «информационный при коммерческом кластере») – достаточно точечного переноса.
Когда смотреть топ. Всегда для outliers из крупных коммерческих групп и для случаев, где модель пишет «похож, но интент другой». На стыке услуги и товара, бренда и общего запроса, города и общего коммерческого – правым оказывается поисковик, потому что страницу вы делаете под его выдачу.
Как проверить качество кластеризации
Ориентиры, по которым я понимаю, что результат годный:
-
Один кластер = одна посадочная. Внутри группы не должно быть запросов, которые требуют разных страниц: товар и услуга, «своими руками» и коммерция, разные бренды, разные города. Если такие есть – либо outlier, либо кластер надо дробить.
-
Покрытие id. Каждый входной id встречается ровно один раз: нигде не потерян и нигде не продублирован. Это проверяется кодом после каждого прогона.
-
Доля confidence: low. Если low больше 15–20% кластеров – либо порог плохой, либо тематика для модели тяжелая, либо промпту не хватает контекста (тематика, регион). Имеет смысл сначала починить вход, а не разбирать каждый low руками.
-
Выборочная сверка с топом. Беру 20–30 крупных коммерческих кластеров и спорные outliers и сверяю пересечение выдачи. Если на выборке топ подтверждает группы – дальше можно доверять схеме и смотреть топ только по low и mixed.
-
Стабильность при повторном прогоне. Фиксирую модель и версию промпта, сохраняю ответы. При повторном прогоне сравниваю только изменившиеся кластеры. OpenAI прямо пишет в документации, что даже одинаковые запросы не гарантируют одинакового ответа – поэтому без фиксации версии «качество» не измерить.
Хороший результат на практике выглядит так: кластеры читаются как будущие посадочные, outliers объяснимы одной фразой, low – единицы, а не треть проекта, а код-проверки по id проходят с первого раза.
Пример того, что выдает нейросеть
На вход модели уходит уже собранный алгоритмом кластер. Допустим, тематика – кондиционеры, регион – Москва, и группа выглядит так:
|
id |
запрос |
|---|---|
|
12 |
купить кондиционер |
|
15 |
кондиционер купить недорого |
|
18 |
сплит система купить |
|
22 |
установка кондиционера цена |
|
27 |
кондиционер daikin купить |
Ответ модели по промпту выше:
{
"name": "купить кондиционер",
"intent": "commercial",
"outliers": [
{
"id": 22,
"reason": "услуга установки, нужна отдельная посадочная"
},
{
"id": 27,
"reason": "брендовый запрос Daikin, отдельная страница"
}
],
"confidence": "high"
}
Как это читать и что делать дальше:
|
id |
запрос |
решение |
причина |
|---|---|---|---|
|
12 |
купить кондиционер |
в кластере |
ядро группы, commercial |
|
15 |
кондиционер купить недорого |
в кластере |
тот же интент покупки |
|
18 |
сплит система купить |
в кластере |
синоним к ядру |
|
22 |
установка кондиционера цена |
outlier → новый кластер |
услуга, не товар |
|
27 |
кондиционер daikin купить |
outlier → другой / новый кластер |
бренд Daikin |
До проверки в одной группе лежали товар, услуга и бренд. После – ядро «купить кондиционер» осталось, два outlier ушли: установка – в свой кластер услуг, Daikin – в брендовый. Именно так схема сокращает объем ручной работы: алгоритм дает черновик, модель помечает чужие id, человек разбирает только outliers и low.
Сколько это стоит
Возьмем условный проект: 10 000 запросов, которые алгоритм разбил на 800 кластеров, в среднем по 12–13 запросов. Мой промпт занимает 298 токенов, сам кластер – еще около 134. На ответ в JSON я закладываю 100 токенов. Итого около 345 тысяч входных и 80 тысяч выходных токенов на весь проект. Это мои допущения, а не замер, но порядок цифр они показывают честно. Цены – по прайсам провайдеров на 23 октября 2026 года, пересчет по курсу ЦБ.
Самые дешевые варианты – GPT-6 Luna у OpenAI и Claude Haiku 5.5 у Anthropic: обе стоят $0,10 за миллион входных и $0,50 за миллион выходных токенов, весь проект – около 6 рублей. DeepSeek Flash выйдет в 8 рублей вне пиковых часов и в 16 рублей в пик. Gemini 3.5 Flash-Lite – около 25 рублей, Gemini 3.8 Flash – около 45, GPT-5.4 mini – около 50. Модели среднего уровня, GPT-6.1 Sol и Claude Sonnet 5, стоят одинаково, $2 и $10 за миллион, проект обойдется примерно в 121 рубль. Claude Opus 5.5 – около 242 рублей, флагман OpenAI GPT-6 Astra – около 605.
Даже самый дорогой вариант стоит меньше часа работы специалиста. Но в этих цифрах есть три ловушки, которые легко пропустить.
Первая – рассуждения. Современные модели перед ответом «думают», и эти скрытые токены оплачиваются как выходные. У GPT-6 Luna, GPT-6 Sol и GPT-6.1 Sol уровень рассуждения по умолчанию – medium. Если модель тратит на каждый кластер лишнюю тысячу токенов размышлений, проект на GPT-6.1 Sol дорожает со 121 до 770 рублей, на GPT-6 Astra – до 3,9 тысячи. Для проверки кластера глубокие рассуждения обычно не нужны: я начинаю с reasoning effort none или low и поднимаю его, только если качество не устраивает.
Вторая – кеширование, на которое многие рассчитывают. OpenAI кеширует повторяющееся начало промпта, и у новых моделей повторное чтение из кеша стоит 10% от обычной цены входа (у GPT-6.1 Sol – 5%). Но только если это начало не короче 1024 токенов. Мой промпт в 298 токенов под кеш не попадает, и скидки не будет. Удлинять промпт ради кеша имеет смысл, только если добавленные примеры действительно улучшают ответы.
Третья – сроки цен. У Gemini 3.8 Flash текущая цена действует до 31 декабря 2026 года, с 1 января она удваивается. Цены DeepSeek зависят от времени суток: пиковые часы – с 4 до 7 и с 9 до 13 по Москве в будни, остальное время вдвое дешевле. Если проверка кластеров не срочная, проще воспользоваться пакетной обработкой: Batch API у OpenAI, Anthropic и Google стоит вдвое дешевле обычных запросов, ответ приходит позже.
И отдельная оговорка про токены. Я считал их токенизаторами OpenAI. У Claude 4.7 и новее, по данным самой Anthropic, новый токенизатор дает примерно на 30% больше токенов на тот же текст, а у Gemini и DeepSeek токенизаторы свои. Так что сравнивать эти цифры между провайдерами можно только по порядку, а не до рубля. Кроме того, это прайсы провайдеров в долларах. Напрямую из России к API OpenAI не подключиться, и через посредника цена в рублях будет выше.
Где модель группирует не так, как поисковик
Чтобы показать, как выглядят ошибки, я прогнал свои 40 запросов через бесплатную локальную модель эмбеддингов paraphrase-multilingual-MiniLM-L12-v2 и агломеративную кластеризацию. Это не та модель, за которую платят по API, и на платных моделях картина может быть лучше. Но характер ошибок показательный.
При пороге 0,2 в одну группу попали «установка кондиционера цена», «чистка кондиционера цена», «заправка кондиционера фреоном стоимость» и «кассетный кондиционер цена». Модель склеила их по слову «цена», хотя это четыре разные посадочные страницы: три услуги и товар. В другую группу попали «инверторный кондиционер что это», «шумит кондиционер что делать» и «кондиционер в рассрочку», которые объединяет разве что конструкция фразы. При этом «сплит система купить недорого» не встала рядом с «купить кондиционер», хотя для покупателя это почти синонимы и выдача по ним, скорее всего, пересекается. Это как раз тот случай, который стоит проверить по топу.
Если порог поднять до 0,35, получается обратная беда: 29 запросов из 40 оказались в одном огромном кластере. Модель увидела общее слово «кондиционер» и решила, что все остальное неважно. Это главная особенность смысловой кластеризации: она группирует то, что похоже по смыслу, а поисковик группирует то, что ранжируется вместе. Чаще всего эти множества совпадают. Но на стыке коммерческих и информационных запросов, услуг и товаров, брендов и городов они расходятся, и правым всегда оказывается поисковик, потому что страницу вы делаете под его выдачу.
На шаге проверки кластера языковой моделью у меня другой список того, за чем я слежу. Модель может придумать название кластера, которого нет в данных, например красивое «Климатическое оборудование для дома» вместо реального «купить кондиционер». Поэтому в промпте прямо сказано строить название из самого частотного запроса. Модель может проигнорировать гео и бренд и оставить «кондиционер daikin купить» в общей коммерческой группе. И модель не обязана отвечать одинаково – поэтому я фиксирую модель и версию промпта, сохраняю ответы и при повторном прогоне сравниваю только изменившиеся кластеры.
Что в итоге
Нейросети не заменяют кластеризацию по топу, а сокращают ее объем. Эмбеддинги и алгоритм делают черновую разбивку почти бесплатно, языковая модель за десятки или сотни рублей на проект проверяет группы и размечает интент, outliers уходят в соседние или новые кластеры, а выдача нужна только для спорных групп. Самая дорогая часть этой схемы – не токены, а время специалиста на проверку. Поэтому деньги имеет смысл тратить не на самую умную модель, а на то, чтобы ошибки модели было легко найти.

Подписывайся!
 ВКонтакте
Есть о чем рассказать? Тогда присылайте свои материалы Марине Ибушевой