Сайт жив, а трафика из Google нет: один неочевидный киллер индексации
Упс, проблема…
Звучит как сюжет триллера для SEO-специалиста? Добро пожаловать в нашу реальность. Мы в Webit столкнулись с этим на одном из проектов. И сегодня расскажем, как искали черную кошку в темной комнате. Спойлер: причина оказалась глубже, чем мы предполагали – проблема была в технических настройках на уровне сервера, которые обычно остаются вне поля зрения первичной SEO-диагностики.
Первая гипотеза: robots.txt
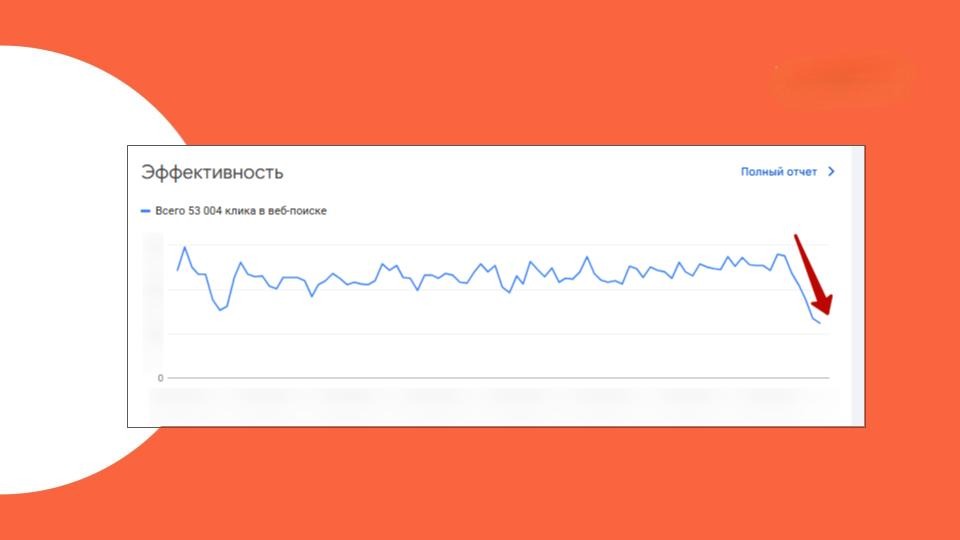
На фоне снижения позиций и падения органического трафика было зафиксировано массовое выпадение страниц из индекса. Мы начали с базовых проверок – убедились, что сайт доступен, страницы открываются корректно, а в панелях вебмастеров нет явных ошибок или предупреждений.
В ходе дальнейшей проверки выяснилось, что Google не мог корректно обработать файл robots.txt. В результате это приводило к проблемам с индексацией страниц.
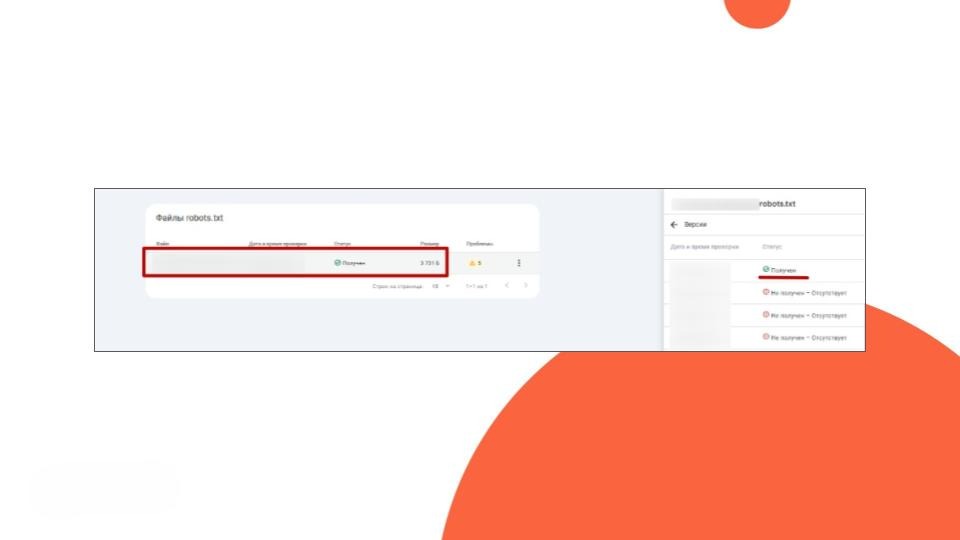
Google Search Console четко сигнализировал: доступ к robots.txt ограничен, файл не проходит переобход URL, страницы не возвращаются в индекс.
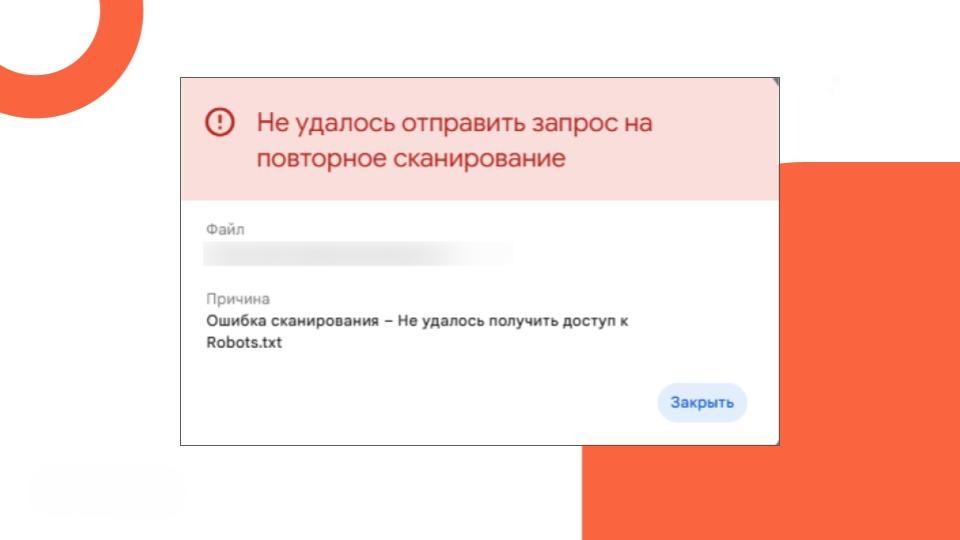
Google не может получить доступ к robots.txt
При анализе мы заметили, что незадолго до возникновения проблемы в robots.txt были внесены изменения: корректировался блок User-Agent, появилась некорректная запись без указания значения *, а также была добавлена директива Crawl-delay. На этом этапе мы рассматривали вариант, что причина может быть связана с синтаксисом или логикой файла.
При этом сами по себе эти изменения не должны были приводить к полной невозможности обработки robots.txt, ведь даже при наличии некорректных директив Google обычно способен обработать файл.
Тем не менее, чтобы полностью исключить этот сценарий, мы восстановили предыдущую заведомо рабочую версию robots.txt и повторно отправили файл на проверку, но он по-прежнему был недоступен для робота. Стало понятно, что дело не в содержимом. Robots.txt просто стал индикатором более глубокой беды, потому что Googlebot пытался до него добраться, но что-то на сервере не пускало.
Мы перешли к технической диагностике.
Вскрытие: логи не врут
Проанализировав логи сервера, мы увидели, что запросы Googlebot регулярно уходят в пустоту. Они не возвращают ошибку 404, не падают с 500-м, они просто... не обрабатываются. Будто робот стучится в закрытую дверь, а ему никто не открывает.
Мы проверили доступность сайта для Googlebot – снаружи все выглядело нормально. Но в логах четко прослеживалась блокировка. Запросы от Googlebot попадали под фильтр и обрывались на уровне сервера.
И тут мы копнули в сторону защиты. На проекте была настроена система Fail2ban – стандартный инструмент для отражения атак. Она отслеживает подозрительную активность и автоматически блокирует IP-адреса, которые слишком часто стучатся на сервер. Все верно, так и должно работать. Но проблема была в одном тонком нюансе: Fail2ban не делал исключений для поисковых роботов. Он видел частые запросы с IP-адресов Googlebot, считал их атакой и… отрезал доступ.
Ирония в том, что система выполняла свою работу безупречно. Для людей сайт был открыт, а для Google – закрыт. При этом никаких внешних признаков не наблюдалось: сайт не падал, не тормозил, не показывал ошибок.
В результате:
-
Googlebot пытался сканировать страницы и получал отказ;
-
Google фиксировал, что доступ невозможен, и выводил URL из индекса;
-
количество исключенных страниц росло;
-
падали позиции, видимость и поисковый трафик.
Решение: корректировка серверной защиты
Мы передали клиенту результаты диагностики и указали, что анализ серверных логов показал причиной выявленных неполадок систему защиты от ботов, настроенную на его стороне. Заказчик внес изменения в настройки серверной защиты.
После этого Googlebot получил доступ к файлу robots.txt, начал стабильно обходить сайт, и страницы одна за другой стали возвращаться в индекс.
Вот что мы увидели в динамике.
-
Доступность robots.txt восстановилась в течение суток.
-
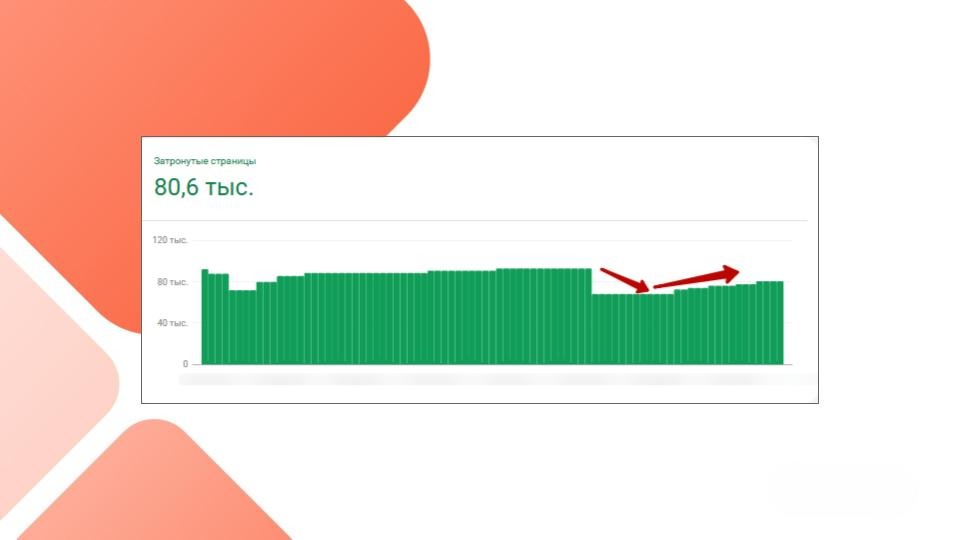
Страницы начали возвращаться в индекс.
-
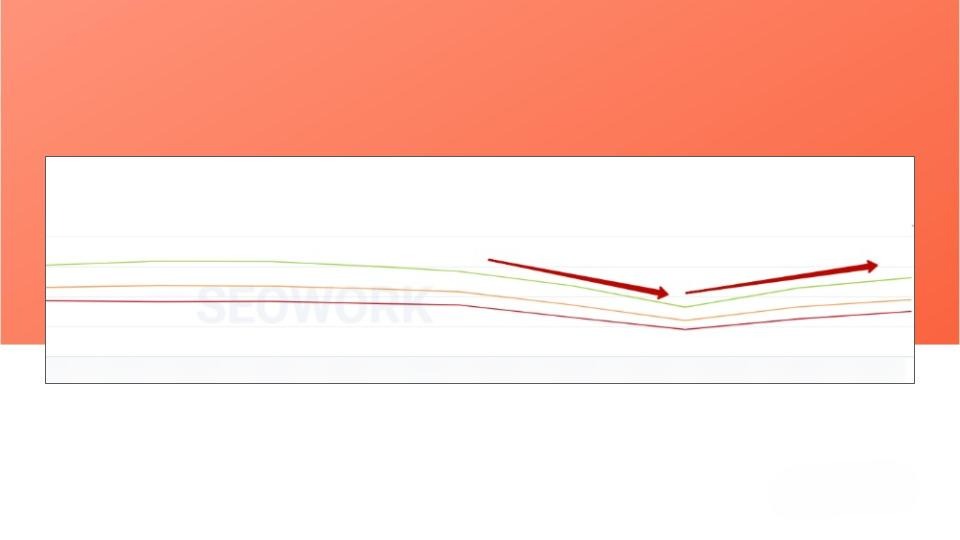
Позиции по ключевым запросам поползли вверх.
-
Трафик постепенно вернулся к прежним значениям.
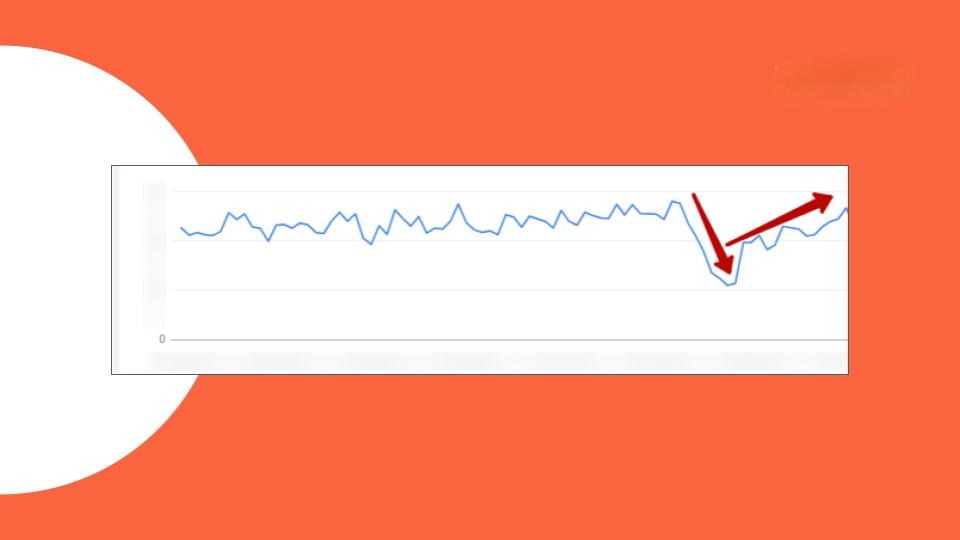
Важно: восстановление заняло время, потому что Google не возвращает страницы в индекс по щелчку пальцев. Но тренд был устойчивым и позитивным.
Инсайты для SEO-специалистов
Эта история – не про ошибку в настройках, а про «слепые» зоны, которые есть у многих компаний. Вот три главных инсайта, которые мы забрали с собой.
Сайт может быть доступен для пользователей и невидим для Google. Страницы открываются, формы работают, технических ошибок нет. Но при этом поисковый робот может быть заблокирован на уровне сервера. Внешне эта проблема никак не проявляется, вы узнаете о ней только постфактум, когда потеряете ощутимую долю трафика.
Search Console не всегда кричит о проблеме на главном экране. В этом проекте в GSC не было красных баннеров или срочных рекомендаций. Проблема пряталась в разделе Настройки → Сканирование → robots.txt и статистика сканирования. Там видна недоступность хоста и ошибки доступа к robots.txt. Если ограничиваться только главной страницей GSC, то можно пропустить критический сигнал.
Индексация – это не только про контент и ссылки, но и про физический доступ. Даже корректный robots.txt, техническая и контентная оптимизация не гарантируют индексацию, если Googlebot не может добраться до сервера. WAF, антибот-системы, Fail2ban, ограничения по IP и частоте запросов – все это может стать невидимым барьером.
Чек-лист: что проверять, если сайт работает, а трафик падает
Сохраните этот список, он может сэкономить вам нервы и бюджет.
Google Search Console
Проверить:
-
ошибки сканирования;
-
проблемы с robots.txt;
-
исключенные страницы;
-
возможность повторного запроса индексации.
В панели вебмастера Google Search Console не всегда сразу показывает на главном экране или в блоке «рекомендации» какие-то проблемы, связанные с доступностью сайта и robots.txt. Зайдите не только во вкладку «Рекомендации». Откройте Настройки → Сканирование → robots.txt и статистика сканирования.
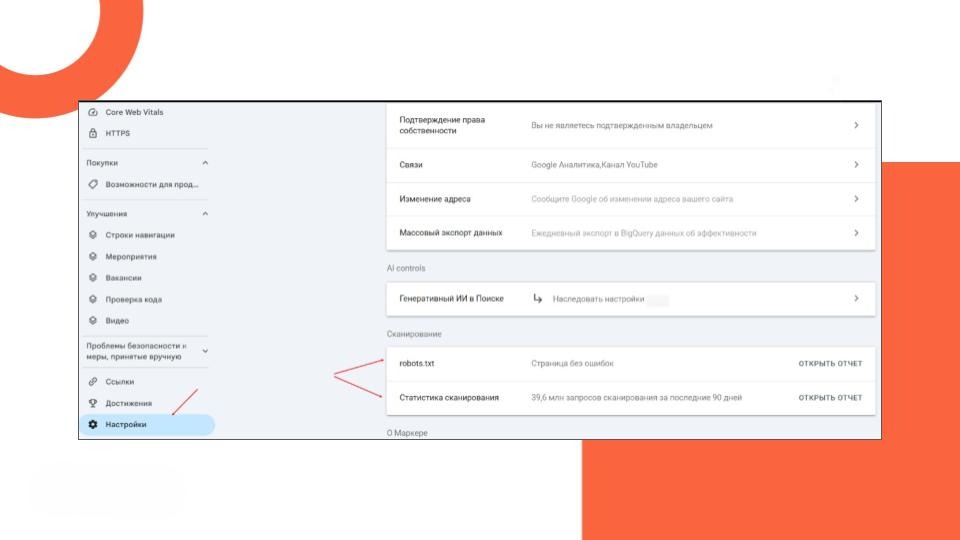
Там ищите:
-
недоступность основного хоста или поддоменов;
-
ошибки доступа к robots.txt;
-
любые аномалии в статистике сканирования.
Robots.txt
Проверьте не только содержание, но и доступность файла. Если он недоступен для робота, то это почти всегда это признак серверной блокировки, а не ошибки в синтаксисе.
Серверные логи
Проверьте, заходит ли Googlebot на сайт, какие коды ответа получает. Если в логах есть отказы без явной ошибки, то это повод копать в сторону блокировок.
Системы защиты (WAF, Fail2ban, антибот-фильтры)
Убедитесь, что IP-адреса Googlebot не попали в черные списки. Проверьте настройки ограничений по частоте запросов.
Эта история закончилась хорошо. Блокировка снята, индексация восстановлена, трафик вернулся. Клиент теперь знает, что серверная инфраструктура тоже может стать зоной риска. А мы в очередной раз убедились: главное в SEO – проверять глубже первичной SEO-диагностики.
Так что если ваш сайт работает «как часы», а трафик падает – возможно, часы просто не видят Googlebot. Проверьте логи.

Подписывайся!
 ВКонтакте
Есть о чем рассказать? Тогда присылайте свои материалы Марине Ибушевой